arXiv 2026
2026-10-22
World Models / Robot Learning
Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Ropedia W0: 统一具身双足移动操作的世界模型
核心元信息
| 维度 | 内容 |
|---|---|
| 主导机构 | 南洋理工大学 MMLab (NTU)、Ropedia、Duke、UCSD、清华大学 |
| 开源状态 | 项目主页已上线,包含 5B (Dense) 与 A14B (MoE, 活跃 14B) 两种模型尺寸,发布 Xp-Teleop 长程双足真机基准 |
| 主干基座 | Wan2.2 视频生成大模型(Wan2.2-TI2V-5B 与 Wan2.2-I2V-A14B,基于 Flow Matching) |
| 数据规模 | Xp-Data:10,000+ 小时人类第一人称视频(含 6,000h 自采四鱼眼多视角)+ 3,000+ 小时多本体机器人数据 |
| 推理性能 | 经过 4 步非对称 DMD 蒸馏与 LongLive 缓存,单卡 21.3 fps 实时生成(640×480) |
| 主要基线对比 | Cosmos3 (Nano 16B / Super 64B)、DreamDojo (2B / 14B)、OSCAR (2B)、RynnWorld-Teleop (5B) |
先看结论 (TL;DR)
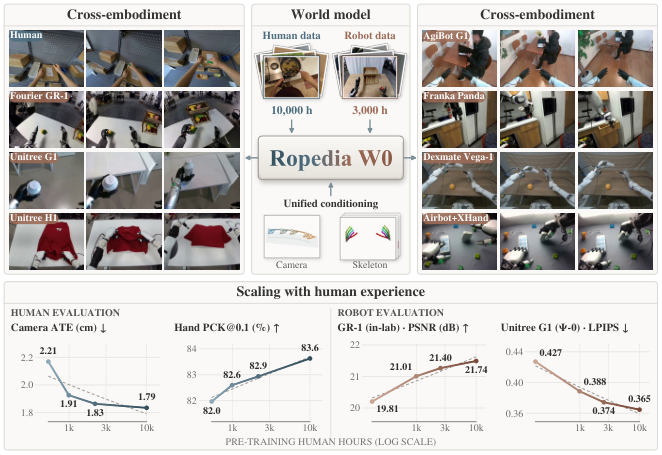
在 Ropedia W0 之前,具身世界模型陷在两个死胡同里:要么把机械臂电机关节角硬塞给网络(导致几十万小时人类生活视频完全无法使用),要么搞隐式的 Latent Action(导致视差动作严重缠绕、一动就崩)。同时,绝大多数模型只能玩台面固定夹爪,一旦进入双足人形机器人的移动操作(Loco-Manipulation),剧烈的行走晃动与手部精细抓取让传统模型全面失效。
Ropedia W0 做了一次极其决绝的技术路线“做减法”:
- 彻底放弃底层电机动作,动作降维投影为 2D 几何线框:用 6 通道 Plücker-ray 光线图控制相机移动视角,用 2D 原生运动学骨架图控制抓取操作;
- 人类日常生活经验真正变成机器人的基石:先在 10,000 小时人类生活视频中完成 Stage 1 预训练,让模型领悟光线视差流动与手指接触因果;再在 Stage 2 中 1:1 混合 3,000 小时机器人数据,掌握机械材质与夹爪接触;
- 零样本碾压大模型:在未见过的真实 Unitree G1 双足长程移动操作基准 Xp-Teleop 上,其 Zero-shot 直接迁移表现直接超过了 Cosmos3-Super (64B) 全量数据微调后的结果(PSNR 16.42 vs 14.81);
- 单卡 21.3 fps 实时落地:通过 4 步因果 DMD 蒸馏与 LongLive KV 缓存,推演 1 分钟长视频不漂移,戴上 VR 头显可做毫秒级即时推演交互,并在真实机器人策略评估上达到 的极高吻合度。
💡 对话攻克与认知记录(Aha Moments & Q&A)
在本次研读与深挖中,我们针对其数学机理、数据工程、跨形态对齐以及实际创新价值展开了刨根问底式的探讨,提炼出以下核心认知突破:
Q1: 普吕克光线(Plücker-ray)为什么能表达相机位移?公式里的叉乘为什么不会为零?
- 攻克认知:如果把世界坐标原点设在当前相机光心上,光线过原点,叉乘确实恒为 0。但论文明确规定:所有相机位姿全部以第 0 帧(初始时刻)的相机坐标系为全局基准点 !
- 到了时刻 ,当机器人往前走 1 米、向右偏移 0.5 米时,相机光心已经平移到了 。
- 公式 中:
- 后 3 维 是单位朝向向量,代表**“头转了多少度”**;
- 前 3 维 是该视线相对于初始原点的角动量力矩向量(大小恰等于原点到该光线的垂直几何距离),代表**“身体平移了多少米”**;
- 根据普吕克坐标的数学性质,在直线上选取任意一点与方向向量叉乘,结果完全恒等。这为全画面的每个像素提供了严格空间对齐的 6 通道几何引导,让扩散模型无需深层自注意力硬记,浅层卷积即可秒懂三维背景视差。
Q2: 人手的 5 根手指,是怎么处理成机器人 2 根手指的平行夹爪的?有做姿态重定向(Retargeting)吗?
- 攻克认知:完全没有做任何重定向算法!论文坚决反对强行将 5 指映射为 2 指。
- 论文采用的是**“各表其态,但画在同一张画纸上(Embodiment-Native Skeletons)”**:
- 人类手画的是 WiLoR/MANO 提取的 21 点 5 指树状分支;
- 二指平行夹爪画的是基座与左右指尖连接而成的“凹”字形线框;
- 五指灵巧手画的是机械连杆的关节拓扑;
- 底层互通的机理:人类在对捏(Pinch Grasp)抓取钥匙时,拇指与食指的运动几何流场与二指夹爪收拢几乎完全一致。扩散模型在 Stage 1 预训练中学到的是**“线条收拢 接触目标 目标与线条同步平移”的接触物理因果律**,在 Stage 2 中仅需将线条外观与材质对应到特定机械本体上,实现了“通用语法驱动多本体方言”。
Q3: 为什么理论上用 URDF 正运动学(FK)就能算出骨架,公开数据集上却必须耗费海量人力做人工纠偏?
- 攻克认知:公开机器人数据集(如 AgiBot、RH20T、Open X-Embodiment 等)直接用公式 投影时,满屏都是车祸现场:
- 机器人移动与剧烈作业导致头部相机外参标定漂移 1~2 度,投射在画面上能飘出去几十个像素;
- 机械臂存在减速器齿隙、传动回差与重载形变,编码器电机角度与物理真实位姿不一致;
- 开源 CAD URDF 与实机组装尺寸存在毫米级误差。
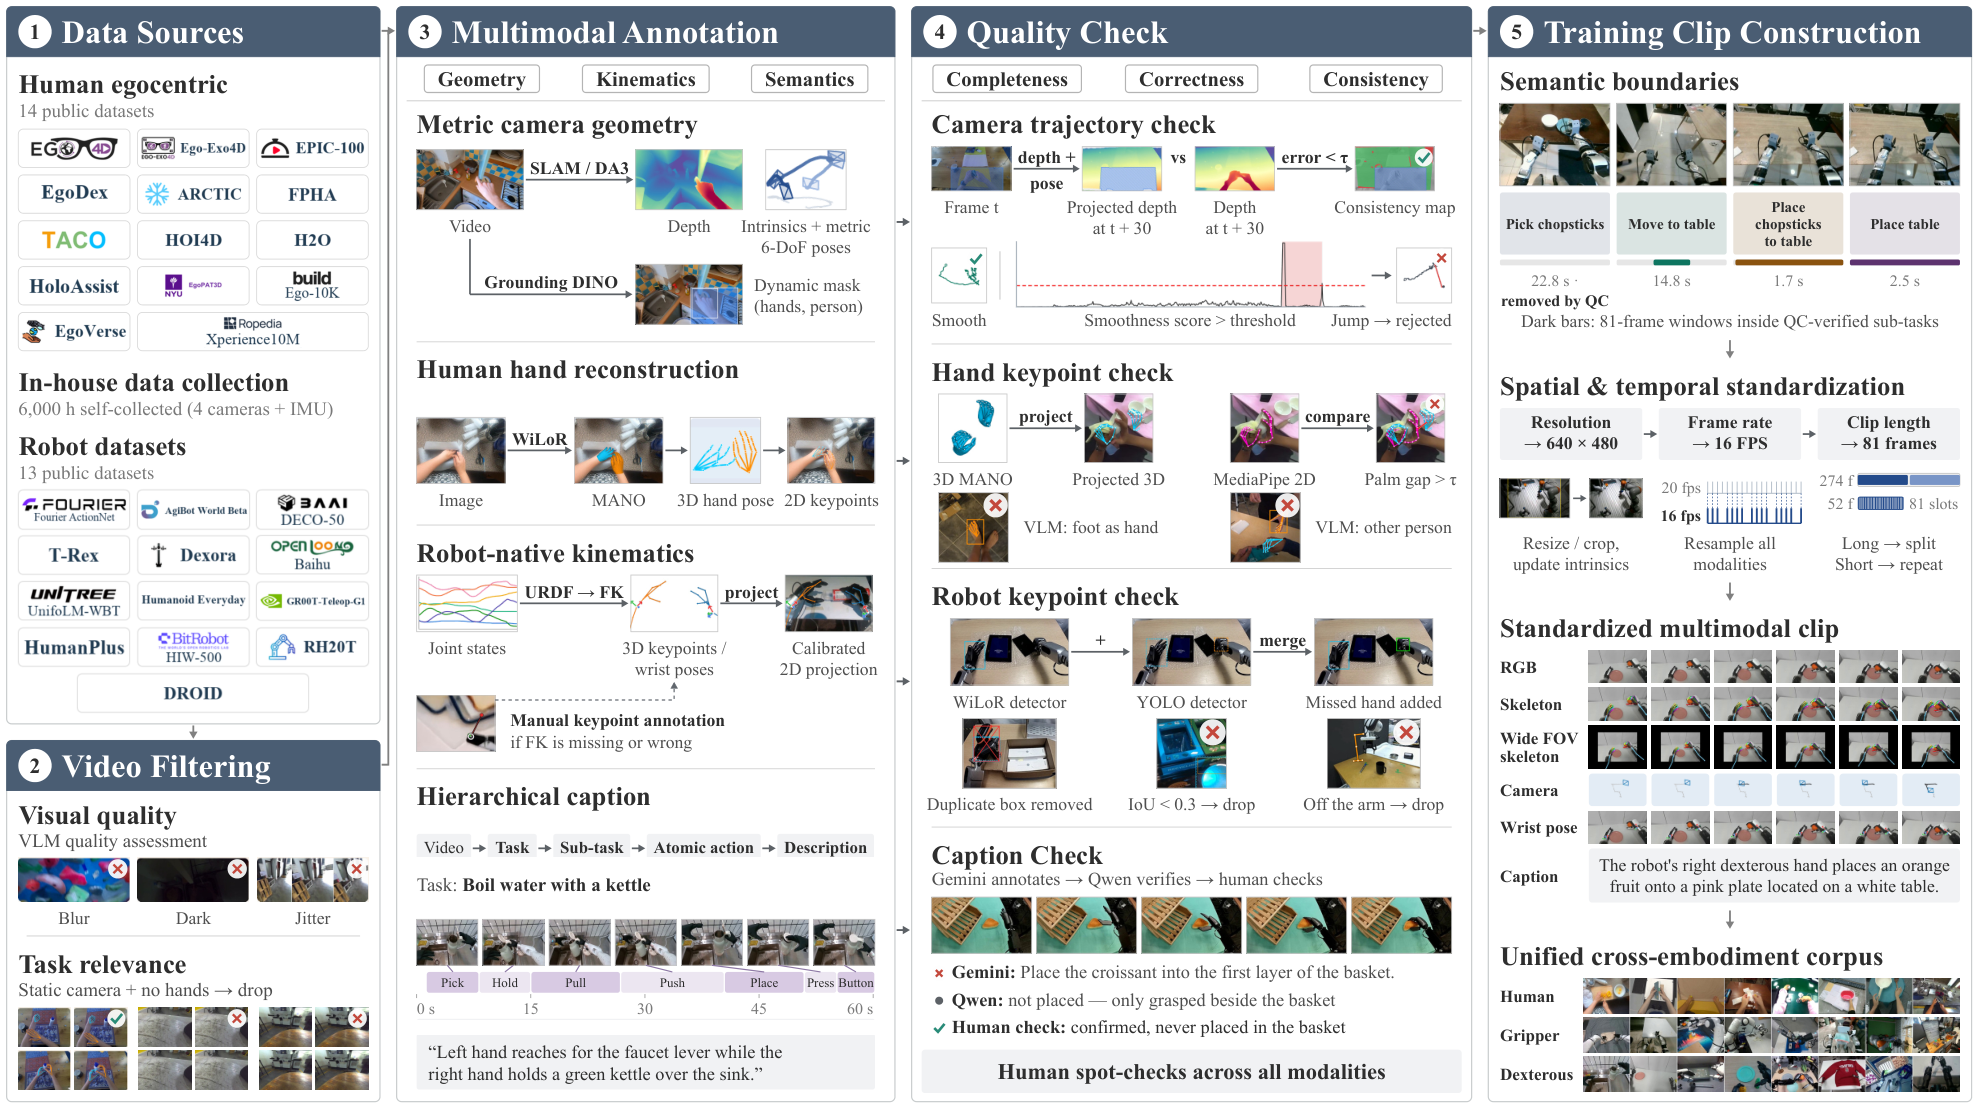
- 若直接拿错位骨架训练,模型会患上“精神分裂”,长出断臂或双重幻肢。因此团队投入大量人力手工标定图像关键点,并训练专有检测器辅助修正,构筑了高一致性真值。
Q4: 训练阶段的光心相对轨迹 究竟从何而来?单目人类视频如何做 SLAM?
- 攻克认知:在自采数据与 Xp-Teleop 上,依靠四鱼眼 + 深度相机 + 头部高频 IMU 跑自研视觉惯性 SLAM(VIO)解算公制轨迹;
- 在只有单目 RGB 的开源人类视频上,团队设计了三道工序:
- Grounding DINO 动态掩模抠除:手部和物体的剧烈运动会彻底带偏 SLAM 特征点,因此在特征跟踪前强行把人手、被操作物体全部掩膜剔除,仅在刚性背景(地面、墙壁)上跑特征匹配;
- DA3-Streaming 估计位姿:利用单目深度与位姿大模型估计轨迹;
- 基于真实里程计的绝对物理尺度标定:利用带真实轮式里程计的机器人视频对单目尺度的未知缩放系数做全局锚定与校准。
Q5: 为什么推理阶段完全不需要跑 SLAM?
- 攻克认知:训练是事后倒查(从已知录像逆推轨迹打标签);推理则是事前预演(根据规划指令推演未来画面)!
- 在推理阶段:
- 脑内规划(Planning):底盘规划器给出的未来候选走位就是 ,机械臂期望关节角就是骨架,直接套公式生成条件图输入世界模型;
- 策略改卷(Evaluation):待评测策略吐出的每一步动作指令直接转为几何图送入推演;
- 实时 VR 交互:VR 头显本身就以 90Hz 输出 6-DoF 头部绝对空间位姿与双手骨架,每秒 21 次灌入蒸馏后的世界模型即可。
Q6: 它是“老工具拼装与算力炫技”还是真正的系统级创新?
- 攻克认知:从单点工具来看,Plücker 来自自动驾驶,Skeleton 来自 ControlNet,Wan2.2 与 Flow Matching 是开源底模,确实没有发明新数学算子;
- 但其真正的突破是关键技术路线的系统级破局:敢于做减法,扔掉电机关节 Token 与玄学 Latent Action,用纯 2D 几何图像线框统一异构本体;攻克了“双足边走边抓”视差与出画盲区;通过极高标准的数据工程洗出 1.3 万小时纯净数据,并把推演延时压到 21.3 fps 单卡实时可用的分水岭。
核心架构与方法拆解
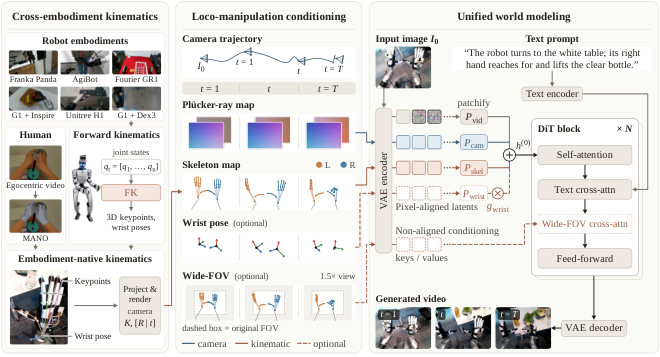
1. 显式运动学控制接口
给定初始观察 、任务描述 以及未来每帧的运动条件序列 ,模型预测未来连续帧:
① 移动端:6 通道 Plücker 光线图 ()
设 为当前帧到第 0 帧相机参考系的旋转矩阵, 为光心在该参考系下的 3D 坐标。对内参为 的任意齐次像素坐标 :
② 操作端:原生运动学骨架 ()
对本体 的第 个机械关节,根据当前关节角度 经 URDF 正运动学 计算基座坐标,再经相机外参 与透视投影 投射到像素: 对错位帧结合人工标注修正后,按本体原生机械拓扑渲染成连线骨架图。
2. 空间未对齐的两个补丁设计
在实际头戴或胸戴相机中,2D 骨架有两大天然物理缺陷:深度歧义与频繁出画。论文给出了精妙的解法:
- 手腕姿态轴(Wrist Pose ):在骨架手腕处显式画出 3D 局部坐标轴(RGB 三向),经卷积投影后通过门控 与视频特征直接相加:
- 1.5x 广角超视距骨架(Wide-FOV Skeleton ): 在双足机器人低头拿东西或伸臂时,手臂伸出画框的比例在测试集中高达 99.4%。论文开辟了一个 1.5 倍视野的外围骨架分支。因其与原画不再是 1:1 像素对齐,故不采用像素相加,而是通过独立的 Cross-Attention 层注入,使画框边缘处的关键点预测误差下降至 11.7 px。
实时交互与长程推演:4 步 21.3 fps 蒸馏机制
为了让原本昂贵的视频扩散大模型能够塞进机器人闭环决策与 VR 交互流,团队设计了三级火箭式的蒸馏体系:
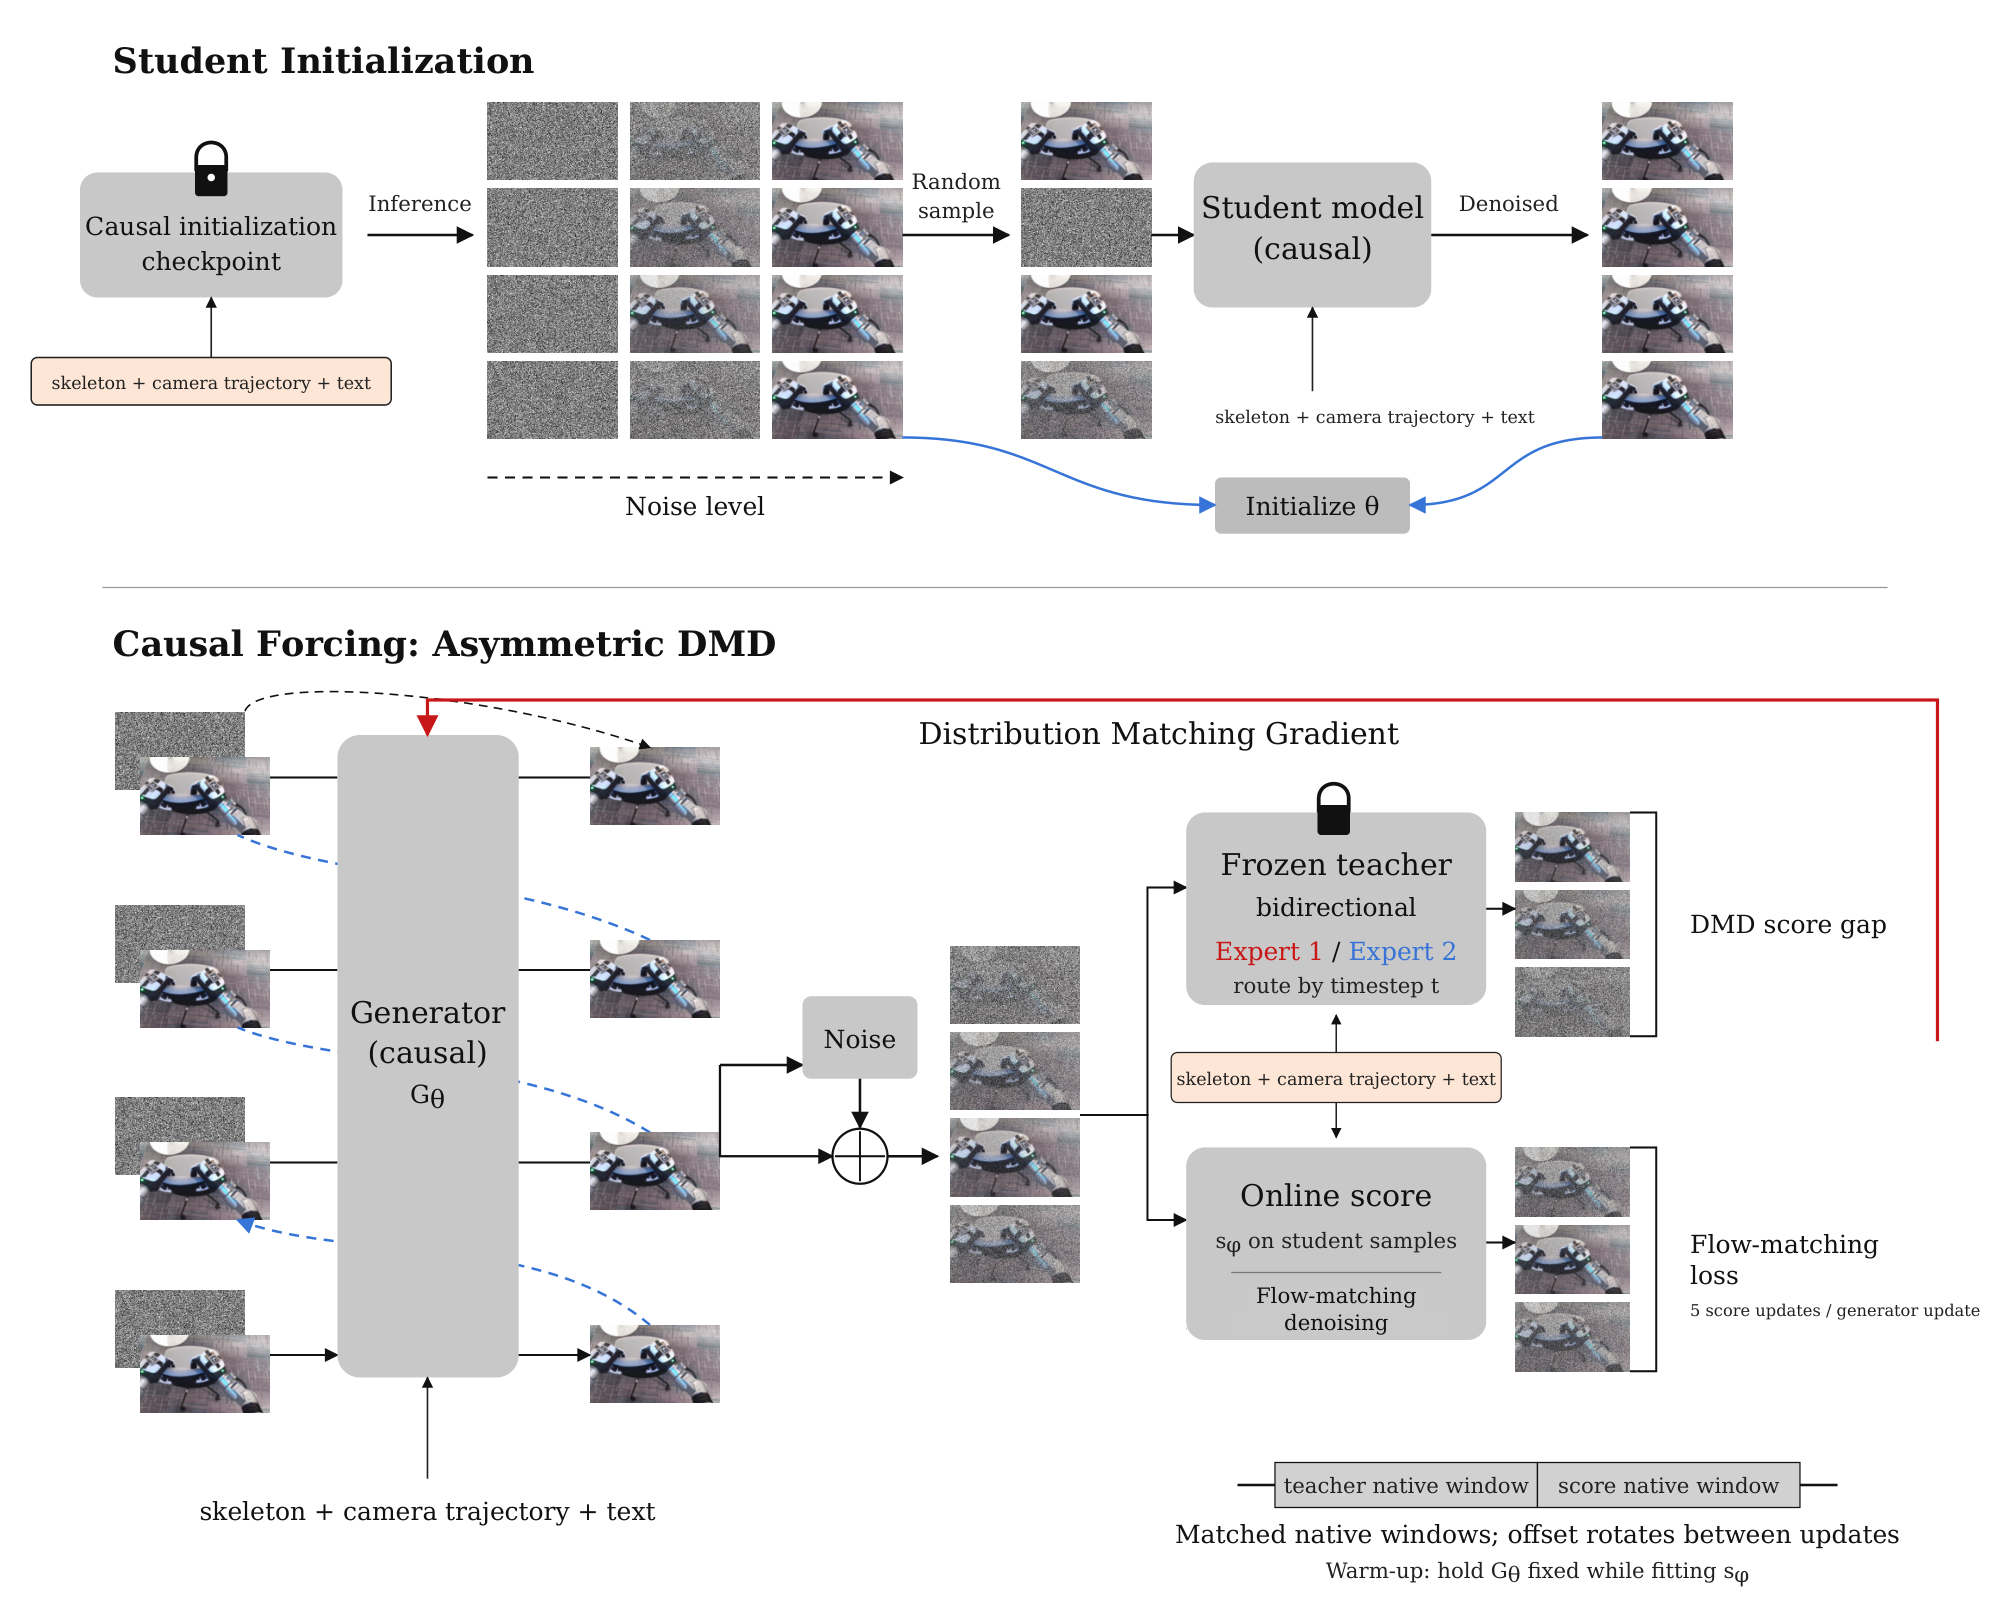
- Causal Forcing(因果初始化):打破传统扩散模型前后双向可见的上帝视角,将其改为严格依赖历史与当前帧的因果自回归结构;
- 非对称分布匹配蒸馏(Asymmetric DMD):
- 冻结一个 50 步双向真实教师模型 (带 CFG);
- 在线训练一个判别假样本的打分网络 ;
- 仅用 4 步去噪步骤,将判别器与教师分布梯度的差值反向传播给学生生成器:
- LongLive 流式 KV 缓存: 引入局部注意力窗口 + 注意力汇聚点(Attention Sink),限制推演显存上限,使推演时长拉长到 1 分钟(61 秒)时,PSNR 仍稳定在 13.98 dB,生成帧率稳定在 21.3 fps。
核心实验与主要结论
1. 跨本体基准全面评测
在五大多本体基准上与主流世界模型展开全面对抗(涵盖零样本、少样本与全量微调):
| 基准数据集 | 本体类型 | 核心对比结果与亮点 |
|---|---|---|
| EgoSuite / OpenAoE | 真实人类第一人称 | 未见过的 200 段人类视频 Zero-shot 评测,ATE/RPE 轨迹误差大幅领先 Cosmos3-Super (64B),PSNR 达 19.77 dB |
| DreamDojo | Fourier GR-1 人形双臂 | 仅用 1% 的后训练数据,Ropedia W0 5B (20.85 dB) 全面超越用 100% 数据训练的 DreamDojo 14B (21.41 dB) |
| Unitree G1 灵巧手双臂 | Zero-shot 直接迁移达 17.36 dB,直接超越了 Cosmos3-Super (64B) 全量数据训练后的 15.73 dB | |
| -HOME | G1 灵巧手移动操作 | 在未见过的家务场景中,Zero-shot 达 19.55 dB,较 Cosmos3 提升近 3.3 dB |
| Xp-Teleop (真机) | G1 全身双足长程移动操作 | 全程双人遥操作长程数据,Zero-shot (16.42 dB) 超越所有基线全量微调表现,未见场景与已见场景同步提升 |
2. 缩放法则(Scaling Law)
论文证实了人类无监督第一人称经验对于机器人下游泛化具有严格的单调缩放效益:
- 随着人类预训练小时数(对数坐标)从几十小时拉升至 10,000 小时,在未见过的真实人类视频、 机器人任务以及 DreamDojo 机器人基准上的 PSNR、SSIM 和相机轨迹精度呈现出近乎纯线性的改善;
- 模型体量从 5B 扩充到 A14B (MoE),跨本体零样本 PSNR 再跃升 +2.2 dB。
3. 下游赋能实测
- 策略自动改卷(Policy Evaluation): 在真实 Unitree G1 的复杂移动操作任务上,用世界模型闭环推演各策略的表现并自动评分,与人类裁判在真实世界实机测试的任务进度评分,皮尔逊相关系数高达 ,排序误差 MMRV = 0。
- 世界-动作模型赋能(FastWAM 初始化): 将 Ropedia W0 5B 预训练权重作为视频主干直接初始化 FastWAM,无需修改动作头结构,在极具挑战的 LIBERO-Plus 评测上成功率从 50.06% 暴涨至 56.82%。
总结与思考 (Takeaways & Critique)
💡 核心启发与工程借鉴
- 别在电机动作的泥潭里硬耗:如果目标是利用海量互联网/人类视频,切忌把电机关节角度作为世界模型的显式条件。将动作降维投影为 2D 骨架,是目前跨越“人 机器人”最经济且最健壮的几何桥梁。
- 大位移务必用光线参数化:对于移动机器人和自动驾驶,简单的 6 个数字或全连接 Embedding 无法抵抗累积视差漂移。基于初始帧的 6 通道 Plücker 光线图是让 2D 扩散模型理解 3D 摄像机刚体运动的标准答案。
- 脏数据清洗是底层壁垒:不要迷信学术公开数据集的标定质量。机械臂 FK 在真实世界中普遍存在漂移与误差,先做关键点纠偏和动态物体抠图,才能训出不飘的世界模型。
⚠️ 潜在局限与落地风险
- 缺少接触力觉与形变推演:纯骨架只能约束刚性位置,对于揉面团、折衣服、拧毛巾等高度依赖非刚体接触形变与顺应性力控的任务,骨架投影无法表征手指与物体的压陷深度。
- 单目 SLAM 尺度误差残留:虽然利用带里程计的机器人进行了尺度标定,但在复杂的无纹理场景中,单目轨迹仍可能存在微小的尺度呼吸效应,长程推演可能累积几何畸变。
- 推理阶段的骨架先验依赖:在闭环控制中,下游规划器必须能生成准确合理的未来骨架;如果上游规划器输出的骨架本身不符合机械臂逆运动学(IK),世界模型推演出的视频也会随之失真。