What Visual Representations Do World Action Models Need?
R²-WAM: 世界动作模型需要什么样的视觉表征
先看结论
这篇论文做的事情很朴素:把「用哪个视觉编码器」和「怎么把它接进模型」拆开,在同一个主干、同一份数据、同一个训练预算下分别测。三句话概括结果:
- 编码器选通用的。13 个候选里通用自监督最强,而且七类扰动的每一类冠军都出自通用组,没有哪个专用编码器在自己的强项上赢。
- 注入用通道拼接。13 个源平均 81.5%,比第二名(独立特征专家 76.4%)高 5.1 点;同一份 DINOv3,换成门控交叉注意力就从 84.0 掉到 73.9。
- 额外编码器按互补性加,不按排名加。C-RADIOv4 单源第二,和 DINOv3 一起用直接掉 5.4 点。
真正的发动机不是「多一路输入」,而是多一个预测任务:只给当前特征 +1.8,只预测未来特征 +7.2。
1 问题:VAE 里没有决策需要的东西
WAM(World Action Model)拿预训练视频生成模型当主干,联合预测未来画面和动作。它的 VAE 是为「把画面重新画出来」训练的,所以保留的是颜色、纹理、光影;而控制需要的是「这是什么物体、在哪、朝哪、接下来会怎么动」。重建任务对这些信息依赖很弱,优化过程会主动把它们压掉。
代价在扰动下暴露得非常直接。只用 VAE 时,视角一变成功率掉到 51.2%,背景一换掉到 62.0%;接上 DINOv3 之后是 64.2% 和 83.9%,平均从 74.7% 到 84.0%。
那为什么不直接接一个「更对口」的编码器?比如补几何用 VGGT,补物体边界用 SAM。论文的答案是:这些专用编码器输出的是中间量(区域、深度、位姿),在视角和外观变化下会失效。分割掩码丢了纹理,深度图丢了语义,而控制需要的是一个对外观变化不敏感的整体场景描述。数据上,专用组均值 80.0,通用组 82.2,差距不大,但前者在任何一列扰动上都没拿到第一。
2 实验怎么搭的
两个必须知道的前提,否则会误读后面的所有数字:
- LIBERO 域内已经饱和。13 个编码器在原来四个套件上都是 97.5–99.1,根本没有分辨力。所以论文把域内结果整个挪进附录,正文全部结论只由 LIBERO-Plus 支撑。这里的「鲁棒性」严格指:在 LIBERO 上训练,直接搬到七类扰动的场景里测。
- 每个配置只训练一次。正文里的
±是评测种子(41/42/43)的方差,不含训练方差。所以 84.0 和 84.49 这一档的排序在统计上靠不住,作者自己也只是说「provides little change」。
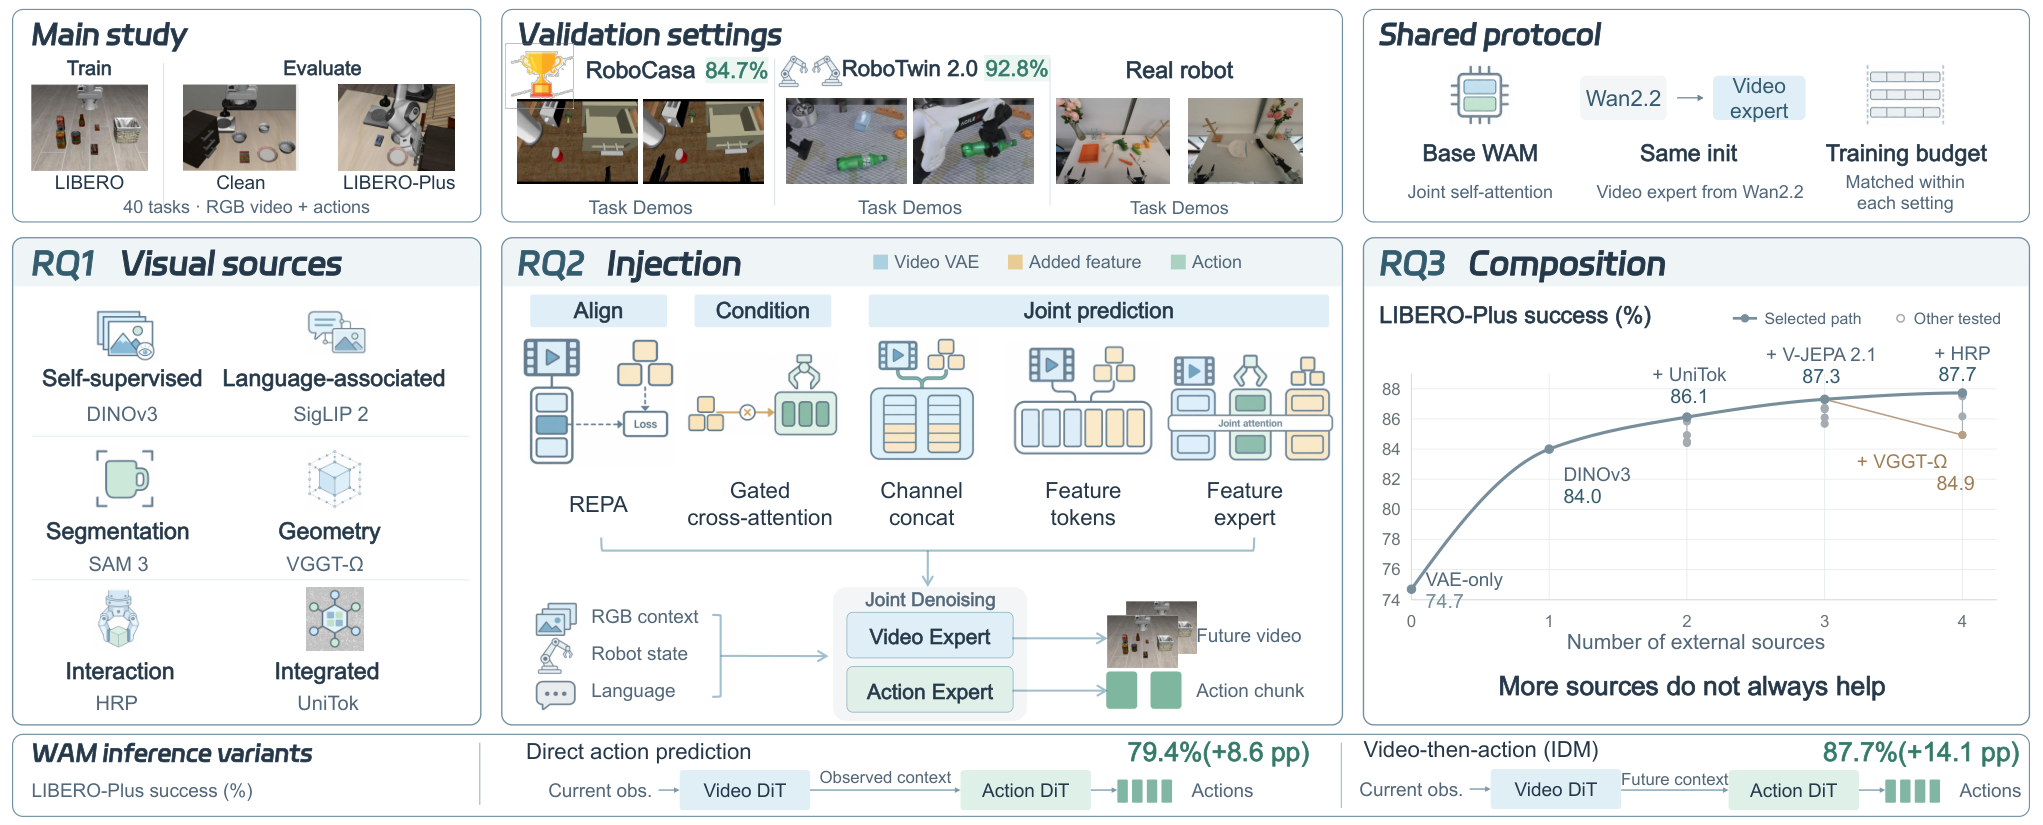
完整的研究框架和验证设置见论文 Figure 1:
3 RQ1:选哪个编码器
13 个候选按预训练目标分成六类,再按「是否面向广泛迁移」分成通用 / 专用两组。把论文 Table 1 的总分拉成条形图:
怎么读这张图:
- 差距不在总分,在分布。通用组 82.2 对专用组 80.0,只差 2.2 点。但把七类扰动拆开看,每一类的最高分都来自通用组:视角 64.2 是 DINOv3,背景 86.2 是 C-RADIOv4,噪声 87.7 是 LingBot-Vision。专用组一次冠军都没拿到。
- 专用能力没有兑换成对应的鲁棒性。最该解决背景杂乱的 SAM 3 在背景扰动上是 75.3,输给 DINOv3 的 83.9;显式建模几何的 VGGT-Ω 在视角扰动上 62.4,也没有赢过 64.2。原因大概在于:它们输出的是中间量,视角一变,中间量本身就错了,而通用表示学到的是对外观变化不敏感的语义与布局。
- 反例比正例更有说服力。VideoMAE V2 同样是自监督,但目标是重建像素,只有 77.5。所以决定表示内容的是预训练目标,不是「自监督」这个标签。用重建目标训练的编码器(VAE、VideoMAE)都在 76–77 区间,用判别 / 预测目标训练的在 82–84。
4 RQ2:怎么把特征给进去
五种机制,差别不在「用什么注意力」,而在外部特征以什么身份进入系统:
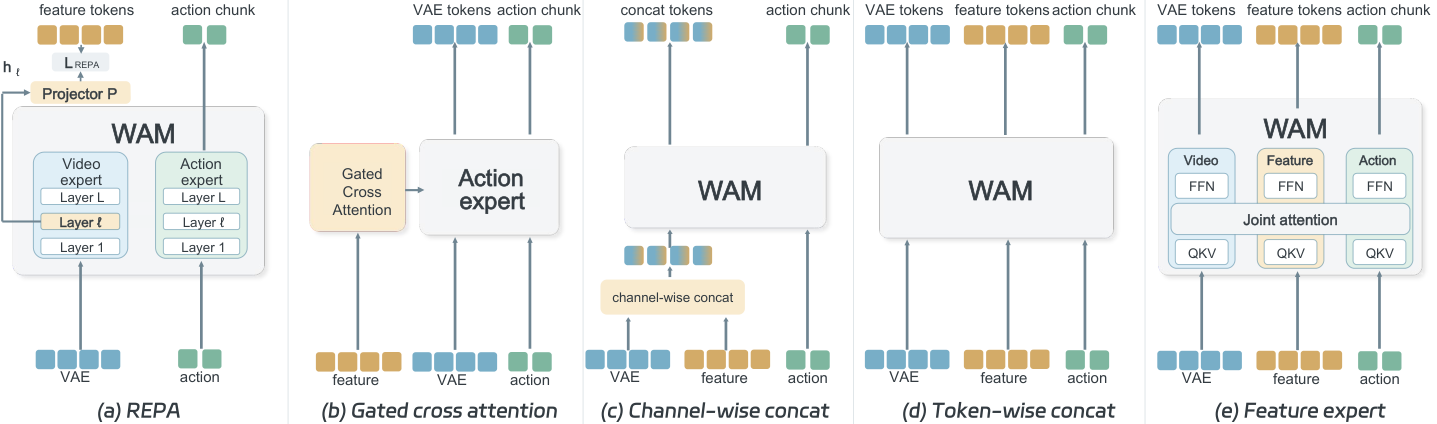
同一份 DINOv3 特征,五种接法最后的 LP 分数:84.0 / 78.1 / 73.9 / 76.1 / 78.7。同样的信息,最多差 10 个点。
论文用三组诊断解释这个差距:
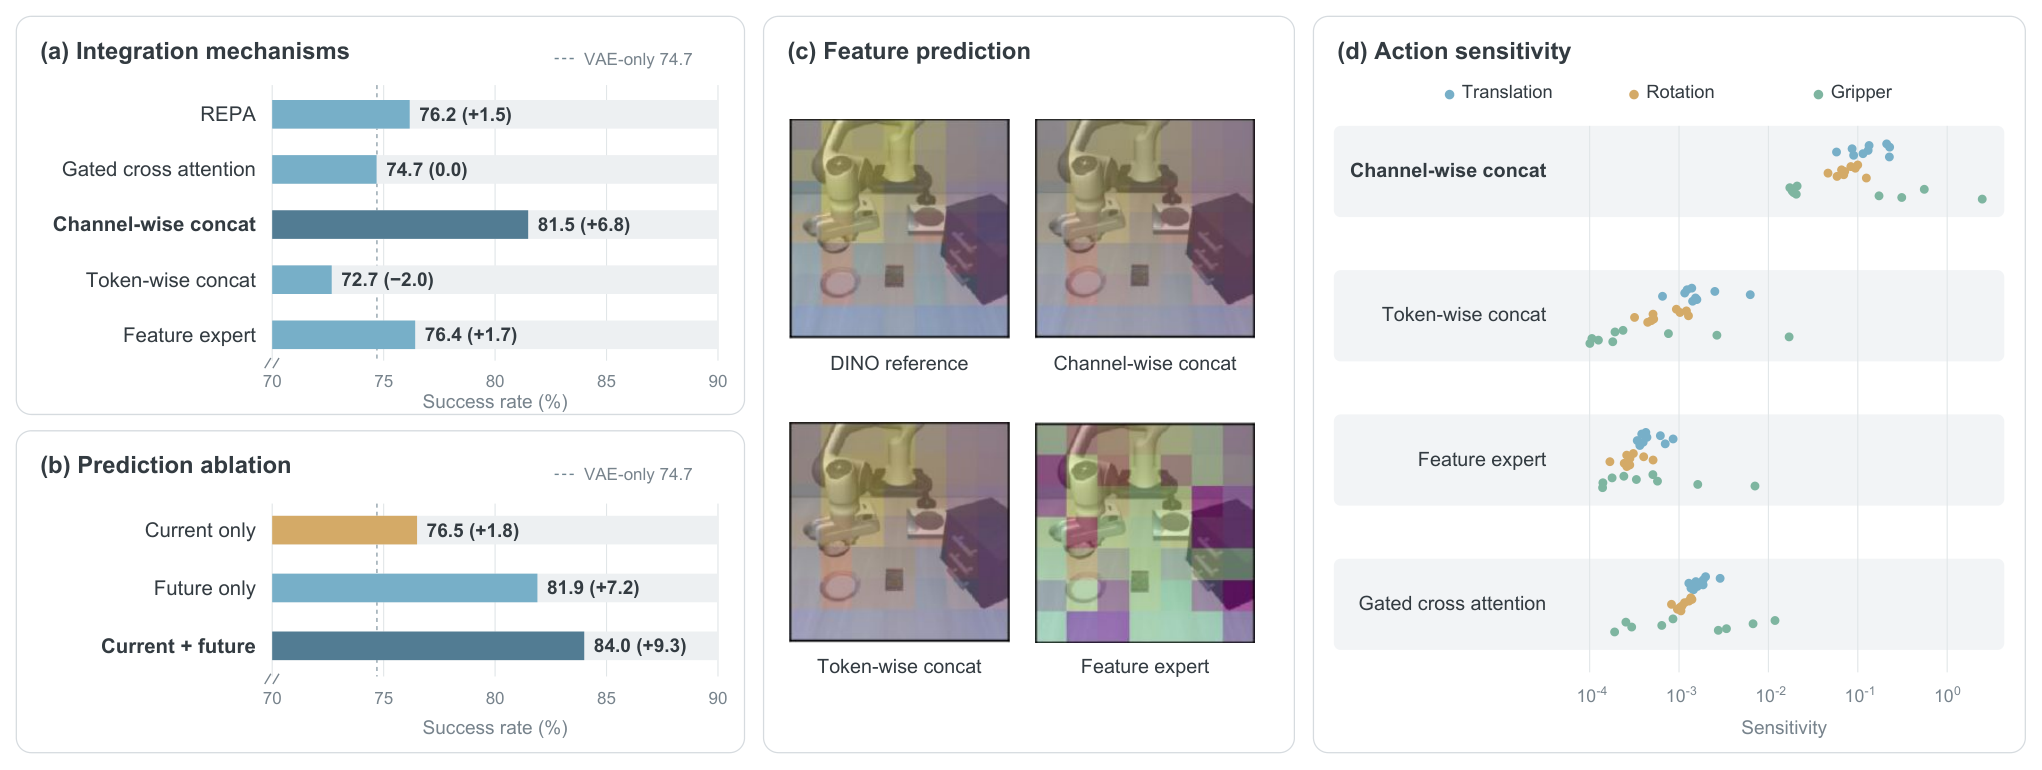
(a) 先看总量。 13 个源的平均:通道拼接 81.5,特征专家 76.4,REPA 76.2,门控交叉注意力 74.7,Token 拼接 72.7。通道拼接比第二名高 5.1 点,比门控高 6.8 点。
(b) 再拆开看增益来自哪。 这是全文最关键的消融:
| 给当前特征 | 预测未来特征 | LP |
|---|---|---|
| ✗ | ✗ | 74.7 |
| ✓ | ✗ | 76.5 |
| ✗ | ✓ | 81.9 |
| ✓ | ✓ | 84.0 |
只把特征当输入,涨 1.8;只让模型预测未来特征(当前特征不给),涨 7.2;两者叠加 9.3,交互项只有 0.3,基本可加。所以起作用的是「多了一个必须完成的预测任务」,不是「多了一路输入」。
这也解释了门控交叉注意力为什么会低于完全不改的基线:它只提供了那 1.8 的上限,还附带一个初始化为 0 的门——模型沿原有通路走更省事,门就一直不开。
(c)(d) 再看特征有没有真的被用上。 通道拼接预测出来的未来特征保留了清晰的空间结构,特征专家预测得最粗糙;动作对特征的局部雅可比敏感度,通道拼接也最高。两条都指向同一件事:只有共享权重、序列不变、并且被预测目标监督的那条通路,才会真正影响动作。
三个原因,按重要性排:
- 预测目标。未来语义特征是一个低熵、稠密、与动作相关的监督信号;每步都有 196 × 2 视角 × 2 时间片的监督点。未来像素里大量高频细节不可预测,MSE 被噪声主导,模型学到的最优策略就是输出一个模糊的平均。
- 梯度共享。特征损失和动作损失改的是同一批参数,所以「预测未来」这件事会改写 30 层主干。特征专家有自己独立的 30 层,梯度到不了动作侧,动作侧也就没有动力去读它的输出——这也是它 78.7 落后 5.1 点的原因。
- 序列不变。通道拼接保持 token 数量、顺序、注意力掩码全部不变,30 层主干的形状直接兼容。Token 拼接把序列翻倍,注意力预算被摊薄,V-JEPA 2.1 从 82.4 直接崩到 49.5。
5 RQ3:要不要多源
以 DINOv3(84.0)为起点往上加,结果在论文 Figure 1 右下那条曲线上:
| 组合 | LP | 变化 |
|---|---|---|
| DINOv3 | 84.0 | — |
| + UniTok | 86.1 | +2.1 |
| + V-JEPA 2.1 | 87.3 | +1.2 |
| + HRP | 87.7 | +0.4 |
| + C-RADIOv4 | 78.6 | −5.4 |
两条规律:
- 增益递减。第一个强通用表征贡献了 +9.3,之后每加一源最多再挤出 3–4 点,第四个源只剩 0.4。作者最终不选 HRP,理由就写在正文里:为了限制辅助编码器的数量和特征预测目标的数量。
- 同源会负迁移。C-RADIOv4 是蒸馏模型,教师正是 DINOv3、SigLIP 2、SAM 3。把它和 DINOv3 拼在一起,两者表示高度共线,联合预测的目标互相拉扯。同理,UniTok 之后再补 SigLIP 2 只剩 +0.2,因为都是图文弱监督语义。
但单源排名不能预测组合价值:HRP 单源只有 79.8(倒数第三),当第四源却能到 87.7。判断依据应该是「它在现有特征之外还提供什么」,而不是它自己考了多少分。
6 配方与验证
R²-WAM = DINOv3 + UniTok + V-JEPA 2.1,通道拼接。
| 评测 | 对照 | R²-WAM |
|---|---|---|
| LIBERO-Plus | VAE-only 74.7 | 87.3 |
| RoboCasa GR1 Tabletop | VAE-only 78.8,此前最好 LAWA 80.8 | 84.7(+5.9) |
| RoboTwin 2.0 | VAE-only 90.6,此前最好 WALA-Wan 92.3 | 92.8(+2.2) |
| 直接动作预测范式 | 70.8 | 79.4(+8.6) |
| IDM 先视频后动作 | 73.6 | 87.7(+14.1) |
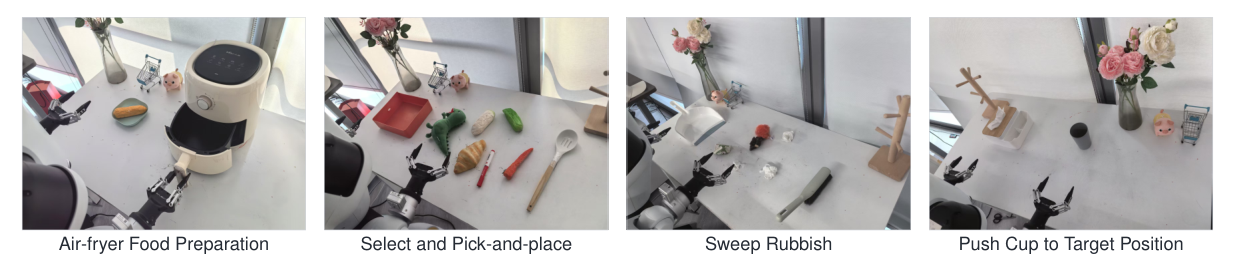
| 真机空气炸锅备餐 | 50.0 | 60.0 |
| 真机指令抓放 | 70.0 | 80.0 |
| 真机清扫(碎屑收集率) | 48.3 | 66.7 |
| 真机推杯 | 65.0 | 75.0 |
比数字更值得记的是跨范式那一栏:同一个配方,在联合去噪、直接动作预测、先视频后动作三种 WAM 范式上都涨。这说明结论绑定的是表示层面,而不是某个特定的生成架构——这也让「用通用表征 + 通道拼接 + 未来预测」这个默认设置更有说服力。
7 实现细节
四个最容易在复现时踩到的点:
- 新增权重必须置零。论文只写「保留预训练 VAE 权重」,没写初始化方式。但如果用常规随机初始化,1024 个新通道的量级会远大于原来的 16 个,第一个前向就崩了。零初始化让训练从基线上方开始,只往上走。
- 噪声独立、时间步共享。两路如果共用噪声,模型可以从视频上的噪声直接推出特征上的噪声,预测任务就退化成一次确定性变换。共享时间步则保证两路信噪比一致,共享输出头不用同时处理两种噪声水平。
- 每个求解步都要把干净前缀写回。 和 是不加噪的条件,求解器更新会污染它们,漏掉这一步会看到性能掉一截。
- 特征标准化。16 个通道和 1024 个通道量级差几十倍,不做逐通道标准化,第一层会被新通道主导。论文未报告这一步,但它是必须的。
另一个隐藏前提是缓存。全量落盘的量级在几百 GB 每源,13 个编码器就是 TB 级;在线提取时,一步训练要前向约 2,300 张图过 ViT-L。这套实验真正的瓶颈在数据管线,不在模型。
8 我的判断
哪些结论站得住:
- 注入方式的差距(10 个点)远大于编码器之间的差距(1–2 个点)。这条在 13 个源上重复了 13 次,是最稳的结论。如果只能做一件事,先改注入方式。
- 预测未来特征贡献 +7.2,条件输入只贡献 +1.8。2×2 消融把这两个因素干净地分开了,交互项只有 0.3。
- 专用编码器没有兑现专用能力。这不是「通用一定更强」,而是「在本实验设定下,专用表示的中间量在分布偏移下更脆弱」。
- 同源蒸馏会负迁移。教师-学生关系导致表示共线,这是一个可预测、可避免的坑。
哪些不能外推:
- 训练极短。百步级微调意味着主干几乎还是 Wan 2.2 原权重。外部表征的边际收益可能在这个区制下被放大;如果训练到收敛,排序是否不变,论文没有验证。
- 单 checkpoint。84.0 / 84.49 / 84.4 这一档的排序不可靠,作者也只做定性表述。
- 只有一个基座、一个评测环境。全部结论来自 Wan 2.2 + LIBERO-Plus;换基座、换真实数据分布会不会变,未知。
- 推理开销完全缺失。最终配方要在线跑三个编码器,控制频率、显存、延迟都没有报告。对真机部署来说,这是最该追问的一项。
- 组合空间有限。只围绕 7 个候选、以 DINOv3 为固定起点,不能外推成「DINOv3 是最优单源」。
9 三个容易误解的说法
「推理时把特征丢掉」不等于白算。 训练时特征预测的梯度已经改写了主干,这部分收益是永久的;推理时特征也仍然参与 10 步联合去噪,动作每步都能看到它。丢弃的只是输出端——特征没有解码器,本来就不产生可见结果。
「通用优于专用」不等于通用万能。 在冻结编码器、百步级微调、LIBERO 分布这三个条件下成立。尤其是「冻结」这一条:如果允许编码器微调,专用表示也许能适配下游,结论可能反过来了。
「多加几个源更好」不成立。 4 源 87.73 对 3 源 87.30,只多 0.43;而加错一个源可以掉 5.4 点。选择依据是互补性,不是单源分数。