Can World and Action Modeling Benefit Each Other under Unified Causal Training?
OneWM: 世界模型与动作生成能否互相受益
先看结论
这篇论文问了一个所有人都觉得「显然有」、但一直没人干净验证过的因果问题:学世界模型对学策略到底有没有帮助?反过来呢?
它的做法不是发明新模块,而是把「动作在训练里扮演什么角色」从一个架构决策降级成一个数据旋钮 ,然后在这个统一框架下做双向对照实验。四句话概括结果:
- 世界模型帮策略,但只在分布外。同分布 LIBERO 上只比 WAM 变体高 2.4 点,还输给 Fast-WAM 3.6 点;到了分布外 LIBERO-Plus 上高出 5.9 点,RoboCasa365 上高出 8.4 点。
- 策略帮世界模型,幅度很小。同架构对照下 PSNR 只涨 0.49–0.62 dB,SSIM 涨 0.008–0.012。真实存在,但远谈不上「重塑」。
- 混合比里真正的自变量不是「干净动作占比」。消融显示干净条件加到 25% 时策略在 OOD 上从 59.27 崩到 38.01,而世界模型指标几乎不动。原因是部署模式()的样本被砍半了。
- 因果掩码的作用不是「防作弊」,而是让「不生成任何一帧视频就能出动作」在训练阶段就成立。世界模型的能力留在权重里,不在推理图里。
一句话判断:这是一篇「问题重构 + 严谨消融」的论文,不是「新架构」的论文。 架构是 MoT + Wan2.2,训练目标是标准 flow matching,两者都是借的。
1 问题:两条互斥的设计路线
想同时要「懂物理」和「会动手」,前人给了四种做法,每一种都牺牲了一头:
| 做法 | 视频看到的动作 | 牺牲了什么 |
|---|---|---|
| WAMmask | 屏蔽 action→video | 学不到「指定动作的视觉后果」 |
| WAMnoisy | 全程带噪动作 | 退化成「预测未来的边缘分布」,控制信息接近于零 |
| 双向联合去噪(Cosmos 3 一路) | 带噪 + 双向注意力 | 视频质量下降(负迁移);且动作分支被锁死在「必须先生成未来视频」的推理图上 |
| 纯世界模型(WM) | 全程干净 | 物理学得好,但完全动作损失 |
论文的观察是:这四个选项其实是同一根轴上的四个刻度。 用「干净动作前缀长度 」参数化, 就是全噪声, 就是全干净,中间连续。既然是一根轴,就没有理由只取端点。
2 方法
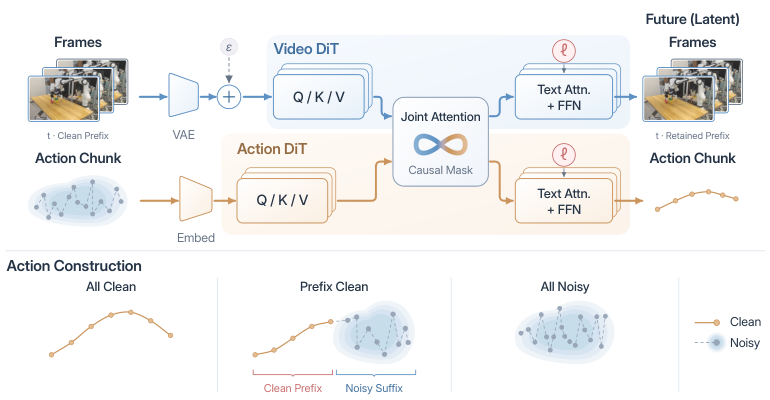
2.1 架构:MoT + 非对称因果掩码
视频专家从 Wan2.2-TI2V-5B 初始化(复用其 VAE 与 umT5 文本编码器),动作专家另起一套。两个专家各有自己的 Q/K/V 投影、FFN 和文本 cross-attention,只有「联合注意力这个运算」是共享的。
这一点必须先说清:所谓「shared video–action architecture」不是权重共享,而是在注意力 K/V 上开了一条互看通道。所以它没有出现 Cosmos 3 那种负迁移——两个专家仍各自保留容量。
基座尺寸(从 HuggingFace 官方 config.json 核对):
| 参数 | 值 |
|---|---|
dim / ffn_dim |
3072 / 14336 |
num_layers |
30 |
num_heads |
24(head dim 128) |
| latent 通道 | 48 |
| 文本编码器 | umT5-xxl,text_len 512 |
| VAE 压缩 | 16×16 空间 / 4× 时间 |
每层约 1.7 亿参数(注意力 3770 万 + FFN 1.32 亿),×30 ≈ 5.1B,对上「5B」的名头。动作专家是在这个 5B 之上额外挂的一小套专家,不是从 5B 里切出来的。
2.2 可见性矩阵:全文的核心
设 是观测块、 是第 个未来帧、 是与该帧对齐的动作段,则:
三条结论,全部是工程级的:
- 动作分支永远看不到未来视频 → 部署时不必生成一帧视频;且训练/部署的可见集完全一致。
- 视频分支看得到动作 → 这是「指定控制 → 视觉后果」的唯一显式监督通路。
- 观测块不看任何动作 → 它是观测的纯函数,可以在任何动作存在之前算出来。
第三条还有一条更硬的理由,是计算顺序上的死锁:部署时动作从纯噪声开始去噪,第一步就要 当条件。如果 的表示依赖动作 token,就变成「要算 得先有动作、要算动作得先有 」。
这三条其实是同一句话:每个 token 在训练时的可见集,必须等于它在部署时能拿到的信息集。
注意力本身是 MoT 形式,两个专家的 K/V 拼接后联合 softmax:
掩码只依赖块索引,与 无关。 这是实现上的关键便利:三种 regime 可以混在同一个 batch 里,不受变长序列或每样本动态形状影响,训练吞吐几乎不变。
2.3 三种条件 regime:同一根轴上的三个刻度
每样本按 60/25/15 抽取 :
| 模式 | 动作输入 | 噪声级 | 覆盖 | 在练什么 | |
|---|---|---|---|---|---|
| 全噪声 | 0 | 全是噪声 | 全部 步 | 部署时的样子:只给画面,自己出动作 | |
| 前缀干净 | 前 步真值 | 前 0 后 | 只算后 步 | 做到一半,接下来怎么办 | |
| 全干净 | 全是真值 | 全 0 | 0 | 我给你动作,你画出后果 |
2.4 逐 token 的噪声级 embedding
论文用一句话带过「action expert receives a noise-level embedding for each token」,但这是整个设计的必要配套,不是修饰。
因为 会「perturb by up to two action steps」,而每个动作块对齐 4 步——所以 可以落在一个块的正中间。 时,第 5 块(动作 17–20)就变成「前 2 步干净、后 2 步带噪」。
于是同一条样本内同时存在两种噪声级:
如果沿用 DiT 惯用的全局 AdaLN 调制(整条样本一个标量 ),这个信息表达不了。逐 token 的噪声级 embedding 同时编码了「脏度」和「角色」:0 表示「我是干净条件,别去噪我」, 表示「我是带噪目标,请预测速度」。
反过来说:正因为有这个编码方式, 才能安全地抖动到块中间;否则必须强制块对齐。块对齐给清晰语义(分界落在一个视觉单元上),±2 抖动防捷径(不让模型学「边界总在 4 的倍数」)。
2.5 联合训练目标
目标速度 (flow matching 约定):
三个容易错过的点:
- 只在 的样本上算。全干净样本对动作分支的贡献是 0。
- 下标 意味着只有「正在被去噪的那部分」进 loss。已干净的前缀是条件,不产生梯度。
- 除以有效元素数,所以后缀长度变化时 loss 尺度不变——partial 样本不是「打折样本」,它以正常强度监督了一个子任务。
2.6 梯度沿哪条路双向流动
这是「互相受益」的机制核心,论文只用一句「provide routes for learning signals from one task to shape representations used by the other」带过。展开是:
| 损失 | 直接更新 | 顺带更新 | 为什么能顺带 |
|---|---|---|---|
| 视频专家参数 | 动作专家的 K/V 投影 | 视频 query 的注意力落在 的 K/V 上 | |
| 动作专家参数 | 视频专家的 K/V 投影(尤其 ) | 动作 query 只能 attend |
所以第二个命题有了精确通路:动作损失把 的 K/V 表征压成「对预测控制有用」的形式,而这个表征同时是视频未来帧 query 的 K/V 来源,视频预测跟着变准。
论文没有做梯度归因实验来证明这条通路,只有端到端指标支撑。[推断]
3 训练细节
3.1 四个域的配置
| 域 | 训练数据 | 训练预算 | 备注 |
|---|---|---|---|
| LIBERO | Spatial / Object / Goal / Long 四套演示联合训练 | 20 epoch,global batch 128 | 沿用 Fast-WAM 配方 |
| LIBERO-Plus | 不训练 | — | 拿 LIBERO 模型直接零样本测 |
| RoboCasa365 | 官方演示集 | 90k 优化步,global batch 1024 | |
| 真机 | 3 任务 × 50 条 = 150 episodes | 20 epoch,global batch 96 | 每任务 15 trials/模型 |
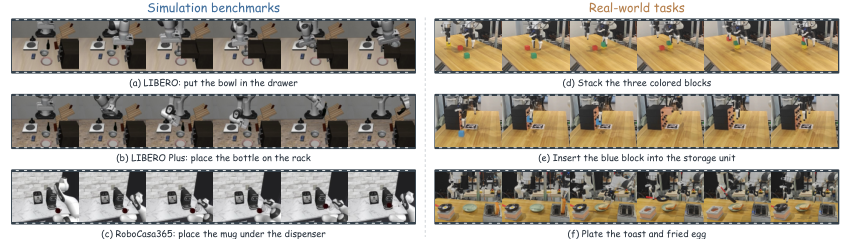
LIBERO-Plus 是完全零样本的。 表里的 59.27% 是在背景、相机、语言、光照、布局、初始位姿、传感器噪声七类扰动全部变化下测出来的,不是重新调过的。
3.2 视频评测集怎么来的
三个 benchmark 本来只用于策略评测,没有给动作条件视频预测准备验证集,所以作者自己造:
| 域 | 参考 rollout 来源 | 规模 |
|---|---|---|
| LIBERO / LIBERO-Plus | 100 条 episode,跨 suite 与七类扰动均匀采样 | |
| RoboCasa365 | Xiaomi-Robotics-1 | 100 条 episode,跨 50 个目标任务均匀采样 |
- 全部多视角(external + wrist)。
- chunk 对齐:LIBERO 系 32 步动作、帧步长 4;RoboCasa365 16 步动作、帧步长 2。两者都正好覆盖 8 个未来帧(不含条件帧)。
- 指标实现:PSNR/SSIM/LPIPS 用 PIQ 0.8;FID 用 Inception-v3 2048 维、;FVD 用 PyTorchVideo 的 I3D-R50、400 维 logits、8 帧 ;FID/FVD 的预测与参考都先过 H.264 QP=20 / YUV420p 编解码再提特征。
3.3 张量流(以 LIBERO 分辨率为例)
| 步骤 | 张量 | 形状 |
|---|---|---|
| 文本 | E |
512 × 4096(umT5),两个专家各一套投影 |
| 观测 VAE | z_ctx |
48 × 1 × 16 × 16 |
| patchify | 64 token × 3072 | |
| 未来 VAE | z_fut |
48 × 8 × 16 × 16 |
| 加噪 + patchify | 512 token × 3072 | |
| 动作嵌入 | 32 token × dim_a |
|
| 序列总长 | — | 608 token |
三种 regime 的序列长度完全相同,差别只在动作 token 的数值与噪声级 embedding——这是能混 batch 的直接原因。
算力分布:576 个视频 token 对 32 个动作 token,约 18:1。所以训练成本基本就是「跑一个 5B 视频模型」,动作专家的边际开销很小。
4 推理:两种模式,一个模型
| 模式 | 动作 | 视频 | 用途 | |
|---|---|---|---|---|
| 世界预测 | 外部给定、全程固定 | 从高斯噪声去噪未来 latent | 评测预测保真度 | |
| 动作生成 | 0 | 从高斯噪声去噪 | 完全不生成 | 真机 / 闭环控制 |
动作生成的实现要点: 表征在整个去噪过程中复用(KV 缓存),只跑一次视觉前向。
| 常规 WAM(先生成未来视频) | OneWM 动作生成 | |
|---|---|---|
| 每 replanning step 前向次数 | 1(V₀)+ 10(视频)+ 10(动作)= 21 | 1 + 10(仅动作) |
| 后 10 步参与注意力的 token | 每步 608 | 32 query × 96 key |
后 10 步几乎可以忽略。实际开销 ≈ 一次视觉前向 + 一次文本前向 + 极小的动作去噪。
这就是「世界模型的能力留在权重里,而不是留在推理图里」的具体形态。
4.1 Endless Dream
把两种推理模式串成闭环:
- 16 轮 × 32 动作 = 512 步;512 × 0.05 s = 25.6 s,反推控制频率 20 Hz,与 LIBERO 设定一致。
- 每轮 8 帧,两阶段各 10 步去噪,固定种子 42。
- 只有初始观测来自环境,之后全部自产;指令不变,无任何校正。
- 关键实现是 :只取最后一帧解码,再重新 VAE 编码成新的 。不做 latent 直接续接,而是走一遍解码→编码往返。代价是每次往返都有重建损失,好处是重编码后的观测与真实观测落在同一分布里。
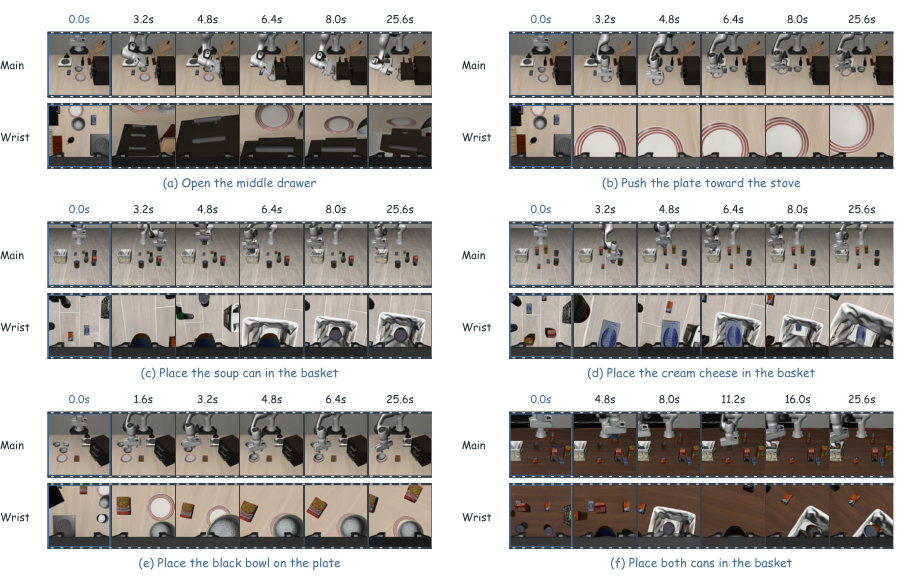
5 实验
5.1 消融一:干净动作条件值多少
控制变量:同一套 MoT、同一份数据、同一 batch、同一预算,三者都同时学视频 + 动作。唯一被改的是「视频分支能看到什么动作」。
| 方法 | LIBERO Avg | LIBERO-Plus Overall | RoboCasa365 Overall |
|---|---|---|---|
| 94.40 | 53.60 | 14.80 | |
| — | — | 16.90 | |
| WorldVLA | 81.80 | 25.00 | — |
| Fast-WAM | 97.60 | 49.70 | — |
| GigaWorld-Policy | — | — | 20.70 |
| GR00T N1.6 | — | — | 21.90 |
WAMmask |
92.45 | 53.37 | 28.32 |
WAMnoisy |
92.60 | 52.50 | — |
| OneWM | 94.95 | 59.27 | 36.68 |
读法:
- 同分布 LIBERO 上只比两个 WAM 变体高 2.4 / 2.5 点,而且还输给 Fast-WAM 3.6 点。
- OOD 的 LIBERO-Plus 上高 5.9 / 6.8 点;RoboCasa365 上比
WAMmask高 8.4 点。 - 分项最能说明问题:噪声 67.08 vs 50.41、语言 79.57 vs 73.85、布局 71.08 vs 62.36、背景 57.34 vs 54.00;但光照 79.86 vs 84.24 反而下降,机器人初始位姿 47.81 vs 47.68 基本没动。
准确表述:干净动作条件带来的不是「更强的动作拟合」,而是对场景外观变化的鲁棒性;它对光照渲染风格和本体状态分布无能为力。如果你的失效模式是光照域偏移或本体动力学差异,别指望它。
5.2 消融二:动作学习值多少
控制变量:同一 MoT、同一 Wan2.2 骨干、同一数据与预算,推理时都给干净动作。唯一被改的是有没有动作预测损失。额外加了 WM_AdaLN(IRASim 风格,用 AdaLN 注入动作)来排除「增益来自 MoT 联合注意力本身」这个混淆。
| benchmark | 指标 | Wan | WM_AdaLN | WM | OneWM |
|---|---|---|---|---|---|
| LIBERO | PSNR ↑ | 20.52 | 20.52 | 22.33 | 22.95 |
| SSIM ↑ | .8045 | .8057 | .8325 | .8423 | |
| LPIPS ↓ | .1817 | .1793 | .1529 | .1458 | |
| FID ↓ | 14.00 | 12.88 | 11.89 | 12.45 | |
| FVD ↓ | 15.83 | 14.73 | 13.68 | 13.58 | |
| LIBERO-Plus | PSNR ↑ | 19.08 | 19.58 | 20.54 | 21.05 |
| SSIM ↑ | .7575 | .7813 | .7937 | .8049 | |
| LPIPS ↓ | .2448 | .2185 | .2014 | .1935 | |
| FID ↓ | 24.01 | 15.91 | 18.06 | 17.01 | |
| FVD ↓ | 49.73 | 29.53 | 32.48 | 31.66 | |
| RoboCasa365 | PSNR ↑ | 23.27 | 22.22 | 24.72 | 25.21 |
| SSIM ↑ | .8176 | .7873 | .8433 | .8515 | |
| LPIPS ↓ | .1292 | .1564 | .1087 | .1015 | |
| FID ↓ | 9.04 | 10.28 | 9.20 | 9.16 | |
| FVD ↓ | 20.23 | 15.98 | 18.55 | 17.74 |
- 与架构完全一致的
WM比,OneWM 在 PSNR/SSIM/LPIPS 三项上三个 benchmark 全胜,FVD 也全胜。 - 但幅度很小:PSNR 只涨 0.49–0.62 dB。证明「有收益」,不足以支撑「显著重塑」。
- FID/FVD 会与 PSNR 冲突:LIBERO-Plus 上
WM_AdaLN的 FID 15.91 / FVD 29.53 明显优于 OneWM 的 17.01 / 31.66。作者给了正确解读——这两个是池化特征分布的距离,把生成的视频随机配给别的动作序列,数值不会变。它们根本不检验「画面是否跟随指定动作」。
这条对整个领域有效:如果你的世界模型评测只报 FID/FVD,你测的可能只是「画得像不像」,而不是「听不听话」。
论文用定性的配对对比补这个洞:同一观测、同一指令、同一条干净动作序列、同一相机,只换模型。看的是夹爪相对物体的位置、瓶身旋转、抽屉位移这类「画面是否跟随动作」的证据。
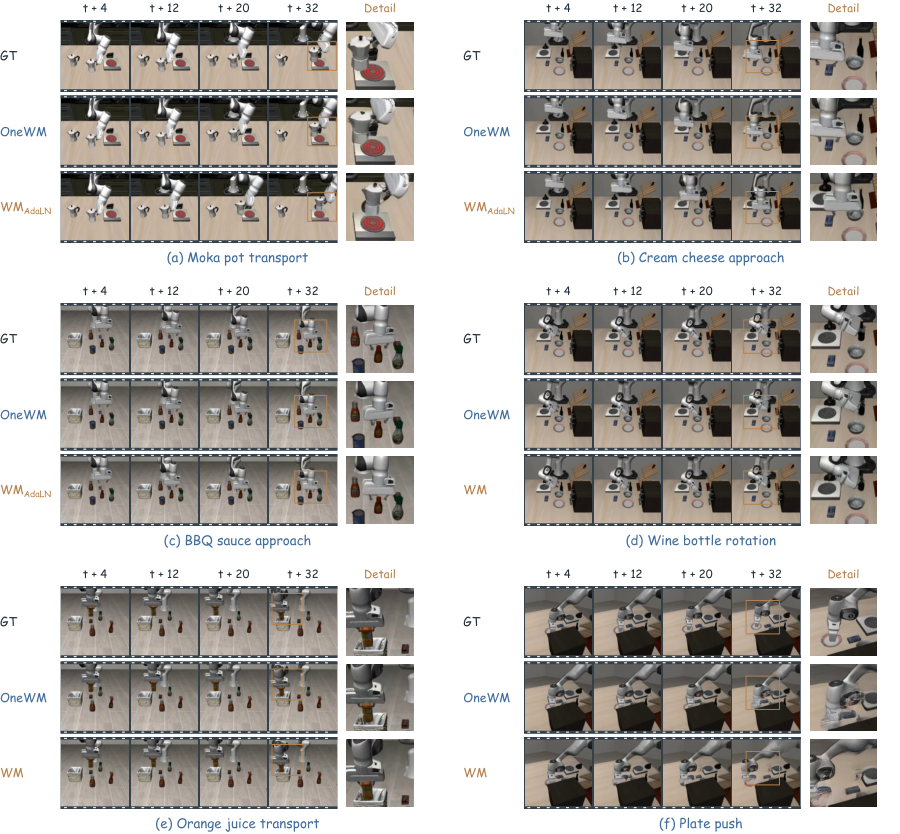
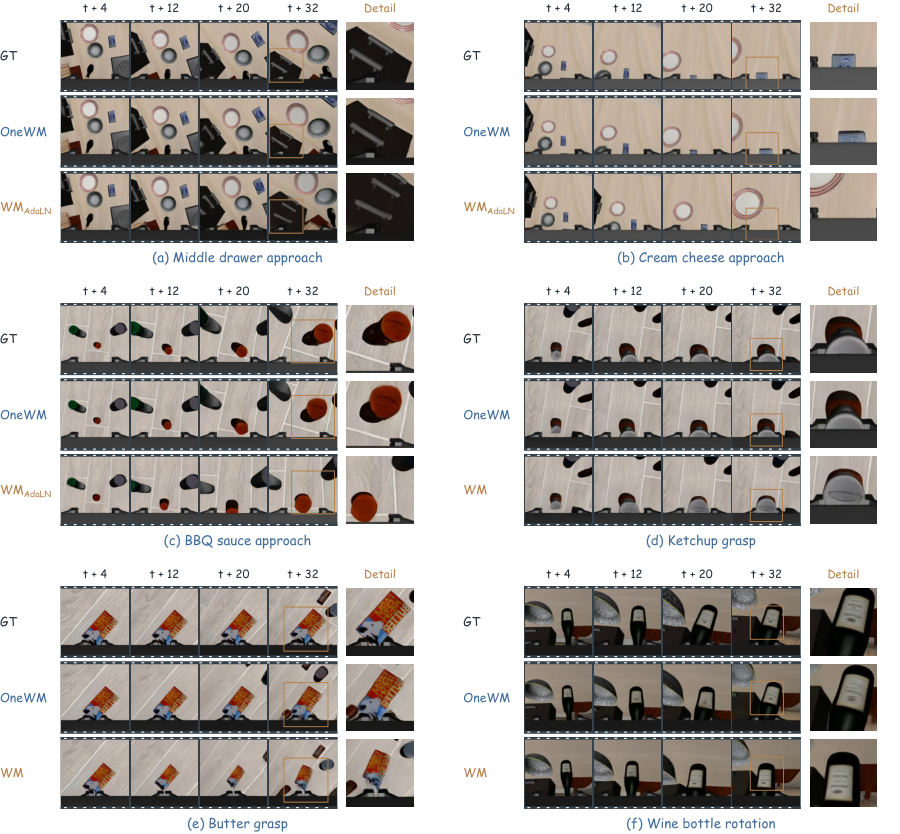
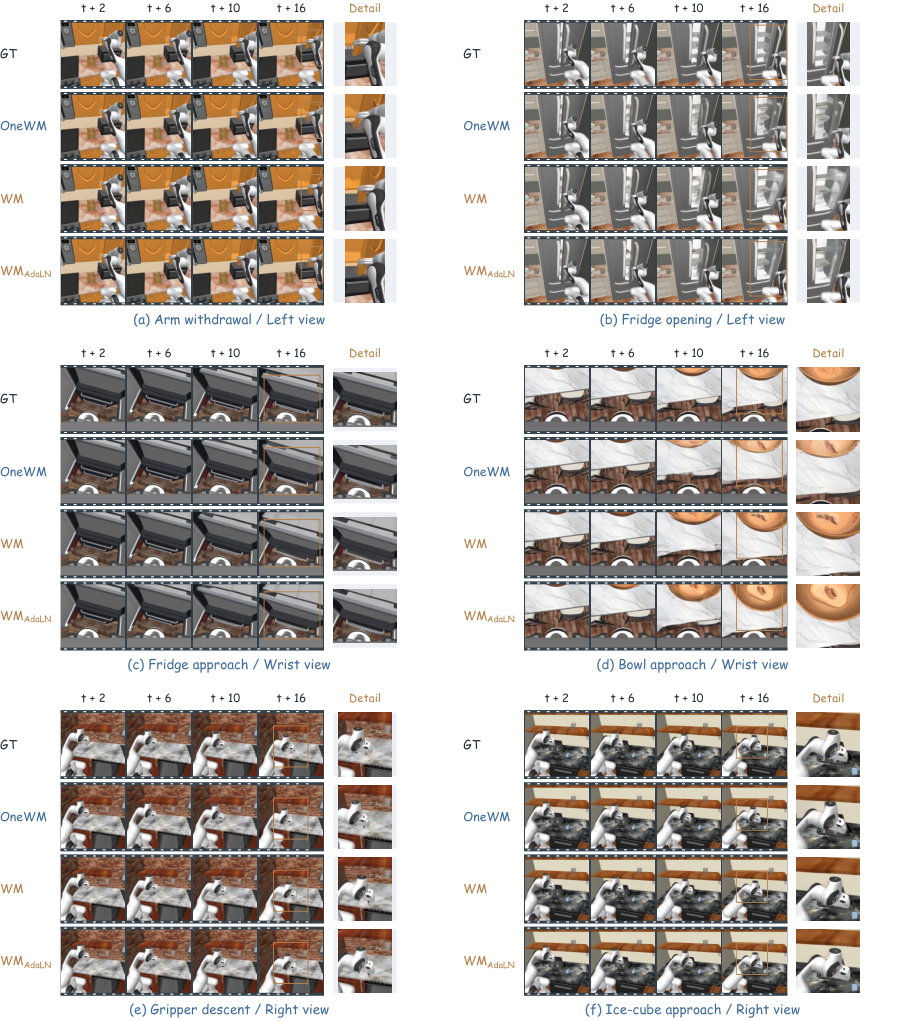
5.3 消融三:条件混合比
| 混合比(全噪/前缀/全干净) | LIBERO SR | LIBERO-Plus SR | PSNR (LIBERO/Plus) | SSIM (LIBERO/Plus) |
|---|---|---|---|---|
| 60/25/15(默认) | 94.95 | 59.27 | 22.95 / 21.05 | .8423 / .8049 |
| 50/35/15 | 95.95 | 56.98 | 22.44 / 20.57 | .8347 / .7943 |
| 30/45/25 | 87.80 | 38.01 | 23.12 / 20.90 | .8443 / .7993 |
现象自洽的解释:
- 50/35/15:同分布 LIBERO 反而最好(95.95),但 OOD 掉 2.3 点。
- 30/45/25:OOD 从 59.27 崩到 38.01(−21 点)。而部署时恰恰是 的全噪声模式,这个 regime 的样本从 60% 掉到 30%——砍了一半。另外 70% 的样本都在做一件更容易的事(有一半甚至四分之三的动作是白送的)。
- 同时世界预测指标基本不动甚至略好(PSNR 23.12 最高):干净条件越多,视频任务越容易,这是「任务变简单」而非「模型变强」。
所以 30/45/25 不是「两个任务双输」,而是把训练信号从部署模式转移到了更容易的 regime。主因是 样本被砍半,token 配额下降(−28%)、有动作 loss 的样本比例下降(85%→75%)只是同方向的次要因素——而崩塌幅度远超它们的线性外推,说明更像跨过了某个阈值。
6 四个 insight
I1 因果掩码是「信息集对齐」,不是建模偏好
最容易被当成实现细节、其实是全文前提的一条。
双向注意力下,动作分支在训练时能偷看「即将被去噪的未来视频 latent」——那是标签泄漏。这条通路在「只生成动作」的部署模式下完全不存在。
但注意:如果部署模式就是同步联合去噪,那未来 latent 确实存在,就不算泄漏。 这种情况下真正的问题是另外三个:
- 延迟:出 32 个动作要先跑完整条视频去噪。
- 漂移:动作读的是模型自己生成的未来画面,策略失效 世界模型失效,引入了一个额外失效点。
- 正方形 vs 对角线:训练时 独立采样, 铺满单位正方形;部署时同步去噪只走对角线。
这才是双向联合去噪的结构性问题——不是它作弊,而是它让训练信号无法归因。
所以 OneWM 的掩码买来的不是「正确性」,是部署形态的自由度:它把「必须生成未来视频」从推理图里摘掉了,代价是放弃那条最容易的通路。
I2 「世界模型看到多少动作信息」是一个旋钮
前人把这件事当成离散选择,OneWM 说这四者是同一条线上的点。一旦接受这个视角:三种 regime 可以混在一个 batch 里(掩码与 无关);「任务变更」变成纯数据构造,不需要改架构、不需要改 loss 形式;两个方向被并入同一批参数。
真正的新意:任务边界不该画在架构上,该画在数据上。
I3 互益是真的,但表现为「泛化」而非「拟合」
| 同分布 LIBERO | 分布外 LIBERO-Plus | |
|---|---|---|
OneWM vs WAMmask |
+2.5 | +5.9 |
OneWM vs WAMnoisy |
+2.35 | +6.8 |
| OneWM vs Fast-WAM | −2.65(输) | +9.57(赢) |
以干净动作为条件的前向动力学监督,不会让策略更会做它练过的任务;它让策略的表征对与任务无关的外观变化更不敏感。
反直觉的推论:如果目标只是刷同分布 benchmark,这套设计是负收益的。
I4 FID/FVD 检验不了「动作条件性」
见 5.2。正确做法是配对指标 + 定性图里的接触点/位姿关系,分布指标只能当辅助。
7 创新点评级
| 候选创新点 | 评级 | 依据 |
|---|---|---|
| MoT 双专家 | ✗ 借用 | Liang et al. 2024 |
| Wan2.2 骨干、flow matching | ✗ 借用 | 官方权重 / Lipman et al. 2023 |
| 因果块掩码 | ~ 具体化 | WorldVLA / Fast-WAM 已有因果变体 |
| 参数化条件 | ✓ 概念创新 | 前人当离散设计选,这里当连续旋钮扫 |
| partial-clean | ~ 重组 | inpainting / prefix-LM 的套路搬到动作块 |
| 逐 token 噪声级 embedding | ~ 必要配套 | 不是创新,是 抖动到块中间的必然要求 |
| 同 batch 混 regime | ✓ 工程创新 | 掩码与 无关 → 零开销混跑 |
| 双向受控消融(含 AdaLN 对照) | ✓ 方法论创新 | 架构匹配,排除了联合注意力的混淆 |
| Endless Dream | ✗ 演示 | 固定 16 轮、种子 42、仅定性 |
一句话:创新在「问题重构 + 严谨消融」,不在「新模块」。
它和 Fast-WAM 的关系需要说准:Fast-WAM 的标题本身就是 Do world action models need test-time future imagination?,结论「不需要」已经给出了。OneWM 的 delta 是证明了不必靠拆模块也能做到:
| Fast-WAM | OneWM | |
|---|---|---|
| 部署时不生成视频 | ✅ | ✅ |
| 视频/动作共享表征 | ❌ 拆成独立模块 | ✅ 同一注意力运算 |
| 因此能谈「互益」 | ❌ | ✅ |
8 局限与复现缺口
按严重程度:
- partial-clean 的必要性完全没证明。三档配比里 partial 从 25% 加到 45%,唯独没有 0%。而趋势是越多越差。所以现有数据只能支持「25% 是可承受上限」,不能支持「它必不可少」——而按论文自己的叙述,partial 是连接两个端点的关键。
- 第一组消融有监督量混淆。
WAMmask/WAMnoisy的动作损失覆盖 100% 样本,OneWM 只覆盖 85%(60% 全量 + 25% 后缀)。所以「干净条件」的增益里混着「监督量不同」。 - 真机每任务 15 trials。粒度 6.7%,三任务合计 45 trials,统计功效很弱。
- 视频评测集只有 100 条 episode,且来自 / Xiaomi-Robotics-1 的 rollout,与训练数据分布不同;无置信区间,PSNR 上 0.5 dB 级别的差异有多少是采样噪声无法判断。
- 跨论文数字不可比。表里的 / Fast-WAM / GR00T / GigaWorld-Policy 是各自论文的数字,数据、预训练、预算都不同。唯一可信的是内部对照。
- 没有任何效率数字。没有参数量、FLOPs、单步延迟、显存。对一个主打「部署时不必生成视频」的方法,这是明显空缺。
复现必须知道但论文没写的:
| 缺口 | 影响 |
|---|---|
| 动作专家怎么初始化 | 致命。从 Wan 复制再改投影,还是随机初始化,是两件不同的事——直接决定能否收敛 |
dim_a、动作归一化、绝对/增量 |
致命。与 flow matching 的目标尺度强相关 |
| 与 的形式 | 高 |
| partial 采样中「块对齐 vs 均匀」的混合比例 | 中。只写「按固定比例」 |
| 训练分辨率与每帧 latent token 数 | 中。决定显存,也决定序列长度 |
| 多视角怎么进序列 | 中。Endless Dream 用主视角 + 腕视角,但没说是否拼成同一序列 |
| 每帧对齐几个动作步 | 低。可从「32 步 / 8 帧 / stride 4」推出为 4,但正文未明写 |
9 三个在讨论中被修正的判断
这轮研读里,有三处最初的直觉是被推翻或修正的,记录在这里:
① 「混合比调节的是动作监督 token 配额」——不完整。 token 配额可以精确算:(前缀均匀采样与块对齐采样的期望都是 )。但真正崩的是「部署模式()的样本被砍半」,而配额只降 28%、样本比例只降 17%——崩塌幅度 36% 远超它们的线性外推。另外 让每条样本的 loss 量级与后缀长度无关,所以「配额」衡量的是覆盖面,不是梯度大小。
② 「双向联合去噪 = 偷看未来」——措辞错误。 如果部署就是同步联合去噪,未来 latent 在推理时确实存在,动作读取它不构成泄漏。真正的问题是延迟、漂移,以及「训练铺满正方形、部署只走对角线」的分布不匹配。只有当部署要跳过视频生成时(所有实时控制系统都会这么选),那条通路才变成纯负债。
③ 「混合比在把容量从策略转移到世界模型」——不准确。 两个专家的 FFN 和投影是各自独立的,不存在参数层面的零和竞争。视频分支拿到的梯度量没变,只是题目变简单了(条件更干净);动作分支拿到梯度的样本变少了。更准确的说法是训练信号分配,不是容量转移。
10 可以往哪走
按性价比排序:
- 补 0% partial 对照 + 按 token 配额重参数化混合比。 现在混合比是个三维单纯形,而真正影响策略的是 样本的比例和一个「表征分裂」的量。如果能证明后者可以用更便宜的辅助损失替代,就能砍掉整个 partial 机制——这本身是一个完整的工作。
- 把 从随机采样换成可学习/自适应。 60/25/15 是手调的;做成按当前 loss 或表征一致性动态调整,就从「数据构造技巧」升级成「训练策略」。
- 检验「表征分裂」假设。 本文给出的最强机制解释是「partial-clean 防止动作表征分裂成『当条件的码』和『当目标的码』」,但论文完全没测。可操作实验:比较「混 regime 训练」与「分 regime 训练」的动作表征(线性探针、CKA 相似度)。如果假设成立,这是比成功率高几个点更硬的贡献。
- 两个泄漏诊断。 ① 推理时把真值未来视频喂给动作分支,看成功率是否暴涨;② 固定 扫 ,看动作 loss 是否对 敏感。健康模型对两者都应不敏感。